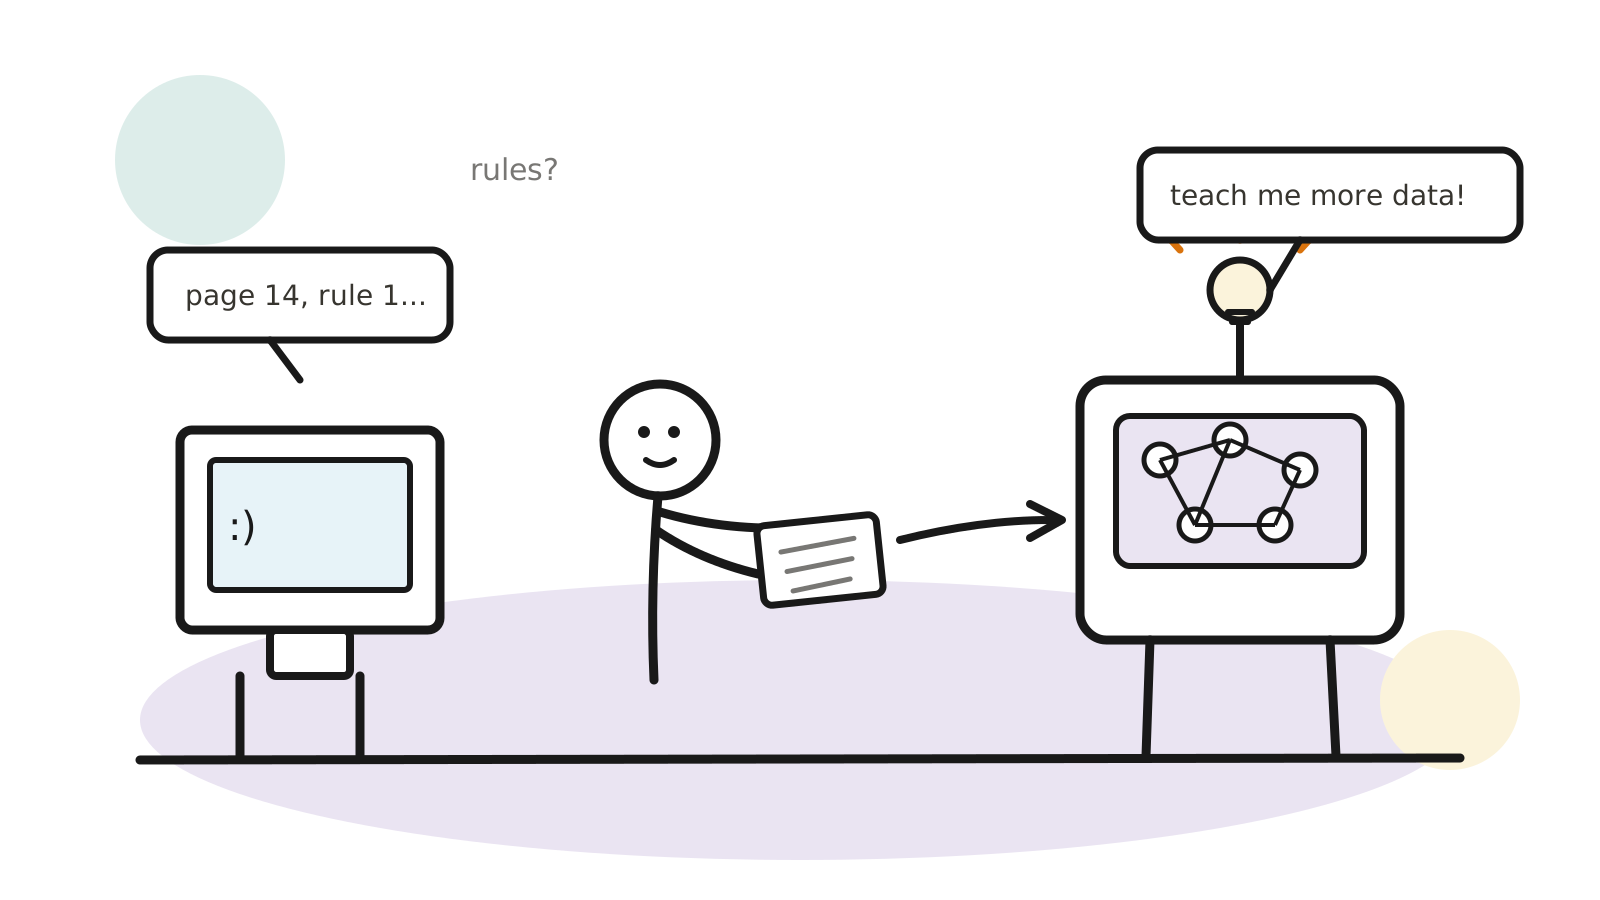
ลองนึกภาพว่าเรารับพนักงานใหม่เข้าร้านกาแฟสองคน
คนแรกทำงานตามคู่มือเป๊ะ ถ้าลูกค้าสั่งลาเต้ก็เปิดหน้าที่ 14 แล้วทำตามทีละข้อ แต่ถ้ามีคนสั่งว่า “ลาเต้หวานน้อย ใช้นมโอ๊ต แต่อยากได้ฟองแบบคาปูชิโน” คู่มือไม่มี เขาก็ยืนค้างเหมือนโปรแกรมขึ้น Not Responding
ส่วนอีกคนดูรุ่นพี่ชงกาแฟมาหลายพันแก้ว ค่อย ๆ จับทางว่าเมล็ดแบบไหนเข้ากับนมอะไร ลูกค้าสีหน้าแบบนี้น่าจะอยากได้รสประมาณไหน ถึงไม่มีสูตรตรงตัวก็ยังพอเดาและปรับตัวได้
โปรแกรมแบบดั้งเดิมคล้ายพนักงานคนแรก ส่วน Machine Learning คล้ายคนที่สอง เราไม่ได้แจกกฎให้ครบทุกข้อ แต่ให้มันเห็นตัวอย่างจำนวนมาก แล้วปล่อยให้มันค้นหารูปแบบด้วยตัวเอง
นี่คือจุดที่เรื่องเริ่มสนุก เพราะเราไม่ได้เขียนแค่ “คำสั่งให้คอมทำงาน” อีกต่อไป เรากำลังเตรียมข้อมูลเพื่อให้คอม “เรียนรู้วิธีทำงาน”
1. AI, Machine Learning และ Deep Learning ไม่ใช่คำเดียวกัน
สามคำนี้ชอบปรากฏในข่าวจนดูเหมือนเป็นญาติฝาแฝด แต่จริง ๆ เป็นวงกลมซ้อนกัน
Artificial Intelligence
└── Machine Learning
    └── Deep Learning
Artificial Intelligence: ร่มคันใหญ่
AI หรือ Artificial Intelligence คือแนวคิดกว้างที่สุด หมายถึงการทำให้คอมพิวเตอร์ทำงานที่ดูต้องอาศัย “ความฉลาด” เช่น วางแผน เล่นเกม สนทนา จำภาพ หรือแนะนำเส้นทาง
AI ไม่จำเป็นต้องเรียนรู้เสมอไป ระบบที่ผู้เชี่ยวชาญเขียนกฎไว้ละเอียดมาก ๆ ก็อาจนับเป็น AI แบบหนึ่งได้ เช่น ระบบวินิจฉัยรุ่นเก่าที่มีกฎว่า ถ้ามีอาการ A ร่วมกับผลตรวจ B ให้พิจารณาโรค C
Machine Learning: ให้ข้อมูลเป็นครู
Machine Learning หรือ ML เป็นส่วนหนึ่งของ AI จุดสำคัญคือเราไม่ได้เขียนทุกกฎด้วยมือ แต่ให้โมเดลเรียนรู้ความสัมพันธ์จากข้อมูล
ถ้าอยากทายราคาบ้าน โปรแกรมแบบกฎอาจเขียนว่า “เพิ่มหนึ่งห้องนอนให้บวกราคาเท่านี้” แต่ ML จะดูบ้านเก่าหลายพันหลัง ทั้งพื้นที่ จำนวนห้อง ทำเล อายุบ้าน และราคาขายจริง แล้วหาแบบแผนที่อธิบายข้อมูลเหล่านั้นได้ดีที่สุด
Deep Learning: นักเรียนที่มีสมองหลายชั้น
Deep Learning เป็นส่วนหนึ่งของ ML อีกที ใช้โครงข่ายประสาทเทียมหลายชั้นในการเรียนรู้รูปแบบซับซ้อน เหมาะกับภาพ เสียง และภาษา
ชื่อ “Deep” ไม่ได้หมายถึงคิดลึกแบบนักปรัชญา แต่หมายถึงมีชั้นประมวลผลหลายชั้น แต่ละชั้นค่อย ๆ เรียนรู้สิ่งที่ซับซ้อนขึ้น เช่น ในงานจำภาพ ชั้นแรกอาจเห็นเส้นและมุม ชั้นต่อมาเห็นพื้นผิว แล้วชั้นสูงขึ้นจึงประกอบเป็นหน้า หู หรือวัตถุทั้งชิ้น
จำง่าย ๆ แบบนี้:
- AI คือเป้าหมายว่าอยากให้เครื่องทำงานฉลาด
- ML คือวิธีหนึ่งที่ให้เครื่องเรียนจากข้อมูล
- Deep Learning คือ ML กลุ่มหนึ่งที่ใช้โครงข่ายหลายชั้นและเก่งกับข้อมูลซับซ้อน
2. Rule-based กับ Machine Learning ต่างกันตรงไหน
สมมติว่าเราจะสร้างระบบแยกอีเมลขยะ
วิธีเขียนกฎ
เราอาจเริ่มจากกฎเหล่านี้
if "รับเงินฟรี" in email:
    result = "spam"
elif "คลิกด่วน" in email:
    result = "spam"
else:
    result = "not spam"
ช่วงแรกดูดี แต่คนส่งสแปมเปลี่ยนคำเป็น “รั บ เ งิ น ฟ รี” หรือส่งเนื้อหาแบบใหม่ กฎเดิมก็หลุด เราต้องวิ่งเติมกฎไปเรื่อย ๆ เหมือนเอาถังไปรองหลังคารั่ว—อุดมุมนี้เสร็จ อีกมุมเริ่มหยด
วิธี Machine Learning
เราเตรียมอีเมลจำนวนมากพร้อมป้ายกำกับว่าอันไหน spam และอันไหนไม่ใช่ โมเดลจะค้นหารูปแบบจากคำ โครงสร้าง ผู้ส่ง ลิงก์ และสัญญาณอื่น ๆ จากนั้นนำสิ่งที่เรียนไปทายอีเมลใหม่
ML เหมาะเมื่อ:
- กฎมีมากหรือซับซ้อนจนเขียนด้วยมือไม่ไหว
- รูปแบบเปลี่ยนแปลงตลอด
- มีข้อมูลตัวอย่างเพียงพอ
- ยอมรับผลแบบความน่าจะเป็นได้ ไม่จำเป็นต้องถูก 100% ทุกครั้ง
ส่วน Rule-based ยังเหมาะเมื่อกฎชัดและต้องแน่นอน เช่น ส่วนลด 10% เมื่อยอดถึง 1,000 บาท หรือการตรวจว่าผู้ใช้กรอกเลขบัตรครบตามรูปแบบหรือไม่
ของจริงมักใช้ทั้งคู่ร่วมกัน ML ทำหน้าที่คาดการณ์ ส่วนกฎธุรกิจคอยวางรั้วไม่ให้ระบบวิ่งออกนอกสนาม
3. Machine Learning สามรูปแบบหลัก
3.1 Supervised Learning: เรียนโดยมีเฉลย
นึกถึงการฝึกทำข้อสอบที่มีเฉลยท้ายเล่ม เราให้ทั้งโจทย์และคำตอบกับโมเดล
พื้นที่ 120 ตร.ม. + 3 ห้องนอน + ทำเล A → ราคา 4.2 ล้านบาท
พื้นที่ 80 ตร.ม.  + 2 ห้องนอน + ทำเล B → ราคา 2.1 ล้านบาท
โมเดลดูตัวอย่างจำนวนมากแล้วเรียนรู้ความสัมพันธ์ เมื่อต้องทายบ้านหลังใหม่ เราใส่คุณสมบัติบ้านเข้าไปและให้มันประมาณราคา
งาน Supervised แบ่งได้คร่าว ๆ เป็นสองกลุ่ม:
- Regression ทายค่าต่อเนื่อง เช่น ราคาบ้าน ยอดขาย หรืออุณหภูมิ
- Classification ทายประเภท เช่น spam/not spam, แมว/หมา หรือรีวิวบวก/ลบ
3.2 Unsupervised Learning: เรียนโดยไม่มีเฉลย
คราวนี้เราเอากล่องของเล่นเทลงพื้นแล้วบอกเด็กว่า “ลองจัดกลุ่มดู” โดยไม่ได้กำหนดว่าต้องแบ่งตามสี รูปร่าง หรือขนาด เด็กจะค้นหาความคล้ายกันเอง
ในโลกข้อมูล วิธีนี้ใช้แบ่งกลุ่มลูกค้าตามพฤติกรรม ค้นหาสินค้าที่มักถูกซื้อร่วมกัน หรือลดมิติของข้อมูลเพื่อให้มองภาพรวมง่ายขึ้น
ข้อควรจำคือชื่อกลุ่มไม่ได้ลอยลงมาจากฟ้า โมเดลอาจสร้าง Cluster 1, 2, 3 แต่คนยังต้องกลับไปดูว่าแต่ละกลุ่มมีลักษณะอย่างไร และตั้งชื่อที่มีความหมายทางธุรกิจ
3.3 Reinforcement Learning: เรียนจากรางวัลและผลลัพธ์
เหมือนฝึกสุนัขให้คาบลูกบอล ทำถูกได้ขนม ทำผิดไม่ได้รางวัล ตัวเรียนรู้จะลองการกระทำหลายแบบ แล้วค่อย ๆ เลือกทางที่ทำให้ได้รางวัลรวมสูงขึ้น
องค์ประกอบสำคัญมีตัวผู้เรียน สภาพแวดล้อม การกระทำ และรางวัล ใช้กับเกม หุ่นยนต์ การควบคุมระบบ และปัญหาที่ต้องตัดสินใจหลายขั้นต่อเนื่องกัน
แต่ไม่ควรเหมารวมว่าระบบแนะนำวิดีโอทั้งหมดเป็น Unsupervised หรือ Reinforcement อย่างใดอย่างหนึ่ง ของจริงอาจผสมหลายเทคนิค ตั้งแต่โมเดลทำนายความสนใจ การจัดอันดับ ไปจนถึงการทดลองว่าเนื้อหาแบบใดทำให้ผู้ใช้พึงพอใจ
4. ก่อนสร้างโมเดล ต้องรู้จักวัตถุดิบ
โมเดลไม่ใช่หม้อวิเศษที่เทข้อมูลอะไรก็ได้แล้วได้คำตอบดีออกมา กระบวนการ ML โดยทั่วไปมีหน้าตาประมาณนี้
ตั้งคำถาม
  ↓
เก็บและทำความสะอาดข้อมูล
  ↓
เลือก Feature กับ Target
  ↓
แบ่ง Train/Test
  ↓
ฝึกโมเดล
  ↓
ประเมินผล
  ↓
นำไปใช้และติดตาม
Feature และ Target
Feature คือข้อมูลที่โมเดลใช้ประกอบการตัดสินใจ เช่น พื้นที่บ้าน จำนวนห้อง อายุบ้าน
Target คือสิ่งที่อยากให้โมเดลทาย เช่น ราคาขายจริง
เปรียบเหมือนเชฟ Feature คือวัตถุดิบบนโต๊ะ ส่วน Target คือเมนูที่เราต้องการ ถ้าบอกให้เชฟทำต้มยำแต่ยื่นแค่แป้งกับน้ำตาล ผลลัพธ์คงไม่ใช่ความผิดของกระทะ
Training Set และ Test Set
ถ้าให้เด็กท่องข้อสอบชุดเดิมแล้วสอบด้วยข้อเดิม คะแนนเต็มไม่ได้แปลว่าเข้าใจ เราจึงแบ่งข้อมูลเป็นสองส่วน
- Training set ใช้ให้โมเดลเรียน
- Test set เก็บไว้สอบด้วยตัวอย่างที่โมเดลไม่เคยเห็น
การแยกนี้ช่วยตรวจว่าโมเดลเรียนรู้รูปแบบทั่วไป หรือเพียงจำข้อมูลฝึกที่เรียกว่า Overfitting
5. โปรเจกต์เล็ก: ให้โมเดลทายราคาบ้าน
ตัวอย่างนี้ใช้ LinearRegression ซึ่งพยายามลากเส้นหรือระนาบที่อธิบายความสัมพันธ์ของข้อมูลให้ดีที่สุด เหมาะสำหรับเห็นภาพพื้นฐานก่อนขยับไปโมเดลซับซ้อน
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error

# ข้อมูลตัวอย่าง: พื้นที่ จำนวนห้อง อายุบ้าน และราคาจริง (ล้านบาท)
houses = pd.DataFrame({
    "area": [50, 65, 80, 100, 120, 140, 160, 180],
    "bedrooms": [1, 2, 2, 3, 3, 4, 4, 5],
    "age": [12, 8, 15, 5, 7, 3, 10, 2],
    "price": [1.8, 2.3, 2.6, 3.5, 4.0, 5.1, 5.2, 6.5]
})

X = houses[["area", "bedrooms", "age"]]  # Feature
y = houses["price"]                         # Target

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42
)

model = LinearRegression()
model.fit(X_train, y_train)

predictions = model.predict(X_test)
error = mean_absolute_error(y_test, predictions)

print("ราคาที่โมเดลทาย:", predictions)
print(f"คลาดเคลื่อนเฉลี่ย: {error:.2f} ล้านบาท")
บรรทัดสำคัญมีเพียงไม่กี่ช่วง:
- เตรียม
Xและy - แบ่งข้อมูลด้วย
train_test_split - สร้างโมเดลแล้ว
fit() - ให้โมเดล
predict() - วัดความคลาดเคลื่อน
ในงานจริง ข้อมูลแปดหลังน้อยเกินไป ตัวอย่างนี้มีไว้ทำความเข้าใจขั้นตอน ไม่ใช่นำไปตีราคาบ้านจริง เพราะราคายังขึ้นกับทำเล สภาพบ้าน ดอกเบี้ย ช่วงเวลา และอีกหลายอย่าง โมเดลที่เห็นโลกผ่านสามคอลัมน์ก็เหมือนนายหน้าที่มองบ้านจากรูประตูเพียงรูเดียว
6. Classification: สอนคอมแยกประเภท
ลองใช้ชุดข้อมูลตัวเลขเขียนมือที่มากับ scikit-learn แต่ละภาพเป็นตารางพิกเซลขนาดเล็กและมีคำตอบว่าเป็นเลขอะไร
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score, confusion_matrix

digits = load_digits()
X_train, X_test, y_train, y_test = train_test_split(
    digits.data,
    digits.target,
    test_size=0.2,
    random_state=42,
    stratify=digits.target
)

model = KNeighborsClassifier(n_neighbors=3)
model.fit(X_train, y_train)

predictions = model.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, predictions):.2%}")
print(confusion_matrix(y_test, predictions))
K-Nearest Neighbors หรือ KNN ใช้หลักว่า “เพื่อนบ้านหน้าตาคล้ายกันมักอยู่กลุ่มเดียวกัน” เมื่อเจอตัวเลขใหม่ มันจะมองหาตัวอย่างที่ใกล้เคียงที่สุดแล้วโหวตคำตอบ
Accuracy อย่างเดียวพอไหม
ไม่เสมอไป สมมติอีเมล 1,000 ฉบับมีสแปมแค่ 10 ฉบับ โมเดลที่ตอบ “ไม่ใช่สแปม” ทุกครั้งได้ Accuracy 99% แต่จับสแปมไม่ได้เลย
เราจึงควรดูตัวชี้วัดอื่นตามโจทย์ เช่น Precision, Recall, F1-score และ Confusion Matrix คำถามสำคัญคือ “ความผิดพลาดแบบไหนแพงกว่า” พลาดเตือนอีเมลหนึ่งฉบับกับพลาดตรวจโรคร้ายแรงมีต้นทุนไม่เท่ากัน
7. ใช้โมเดลสำเร็จรูป: Image Classification
เราไม่จำเป็นต้องฝึกโมเดลทุกตัวเอง Hugging Face มีโมเดลและเครื่องมือ pipeline ที่ช่วยให้ทดลองงาน AI ได้ง่ายขึ้น
ติดตั้งใน Colab:
!pip install transformers torch pillow -q
ลองให้โมเดลจำแนกรูปจากไฟล์ในเครื่อง:
from transformers import pipeline
from PIL import Image

classifier = pipeline("image-classification")
image = Image.open("my_photo.jpg")

results = classifier(image)
for item in results[:5]:
    print(f"{item['label']}: {item['score']:.1%}")
ผลอาจออกมาประมาณนี้
tabby cat: 91.2%
tiger cat: 5.7%
Egyptian cat: 1.8%
ตัวเลข Score คือค่าที่โมเดลใช้จัดอันดับความเป็นไปได้ภายใต้ตัวเลือกและวิธีคำนวณของมัน ไม่ใช่ใบรับรองว่า “ความจริงข้อนี้ถูก 91.2%” เสมอไป ถ้ารูปมืด มุมแปลก หรือเป็นสิ่งที่โมเดลไม่เคยเรียน มันก็ยังอาจตอบอย่างมั่นใจแต่ผิดได้
ทดลองอย่างมีระบบได้ด้วยการเปลี่ยนทีละปัจจัย:
- รูปชัดเทียบกับรูปเบลอ
- วัตถุเดี่ยวเทียบกับหลายวัตถุ
- ภาพปกติเทียบกับมุมแปลก
- สิ่งของทั่วไปเทียบกับสิ่งของเฉพาะท้องถิ่น
เราไม่ได้แค่เล่นให้ AI ทาย แต่กำลังสำรวจ “ขอบเขตความรู้” ของโมเดล
8. Sentiment Analysis: ให้ AI อ่านอารมณ์ในข้อความ
Sentiment Analysis คือการจำแนกว่าข้อความมีความรู้สึกเชิงบวก ลบ หรือในบางโมเดลมีระดับกลาง
from transformers import pipeline

sentiment = pipeline("sentiment-analysis")

texts = [
    "I love this course. The examples are very clear!",
    "The app crashes every time I open it.",
    "Great, another meeting that could have been an email."
]

for text, result in zip(texts, sentiment(texts)):
    print(text)
    print(result)
ประโยคสุดท้ายคือกับดัก คำว่า “Great” ดูบวก แต่ความหมายรวมประชดประชัน โมเดลบางตัวอาจพลาด เพราะภาษาไม่ได้มีแค่คำศัพท์ แต่มีบริบท น้ำเสียง วัฒนธรรม และสิ่งที่ไม่ได้พูดออกมาตรง ๆ
อีกเรื่องที่ต้องระวังคือภาษา โมเดลที่ฝึกภาษาอังกฤษอาจไม่เหมาะกับภาษาไทย หากจะใช้จริงควรเลือกโมเดลที่รองรับภาษาเป้าหมาย อ่าน Model Card และทดสอบด้วยข้อความจากบริบทจริง
งานที่นำไปต่อยอดได้ เช่น:
- สรุปเสียงลูกค้าจากรีวิวจำนวนมาก
- คัดข้อความร้องเรียนเร่งด่วน
- ดูแนวโน้มความคิดเห็นต่อแคมเปญ
- ช่วยทีมบริการลูกค้าจัดลำดับคิว
แต่ไม่ควรใช้แทนมนุษย์แบบไร้การตรวจสอบในเรื่องละเอียดอ่อน เช่น ประเมินสภาพจิตใจ ตัดสินพนักงาน หรือปฏิเสธสิทธิของใครสักคนจากข้อความสั้น ๆ
9. Text Generation และ LLM: นักเดาคำที่เก่งจนน่าตกใจ
โมเดลภาษาขนาดใหญ่หรือ LLM เรียนรู้รูปแบบภาษาจากข้อความปริมาณมหาศาล งานพื้นฐานคือทายว่า Token ถัดไปควรเป็นอะไร
ถ้าเห็นข้อความว่า
วันนี้อากาศร้อนมาก อย่าลืมดื่ม...
คำว่า “น้ำ” น่าจะมีโอกาสสูงกว่า “ตู้เย็น” หรือ “ดาวอังคาร” โมเดลเลือกต่อทีละ Token ซ้ำไปเรื่อย ๆ จนกลายเป็นย่อหน้า บทความ หรือโค้ด
นี่ไม่ได้แปลว่าโมเดลแค่สุ่มคำมั่ว ๆ เพราะระหว่างฝึกมันเรียนความสัมพันธ์ซับซ้อนของภาษา แนวคิด และโครงสร้าง แต่กลไกการสร้างคำตอบไม่ได้มีฐานข้อมูลความจริงติดอยู่ทุกประโยค จึงเกิด Hallucination ได้—ตอบลื่นไหล ดูมั่นใจ แต่รายละเอียดไม่มีอยู่จริง
ตัวอย่างสร้างข้อความด้วยโมเดลสำเร็จรูป:
from transformers import pipeline

generator = pipeline("text-generation", model="distilgpt2")

result = generator(
    "In the future, learning to code will",
    max_new_tokens=50,
    do_sample=True,
    temperature=0.8
)

print(result[0]["generated_text"])
temperature เปรียบเหมือนปุ่มความกล้าในการเลือกคำ ค่าต่ำมักเลือกทางปลอดภัยและคาดเดาง่าย ค่าสูงเปิดโอกาสให้คำที่ไม่ธรรมดาถูกเลือกมากขึ้น จึงสร้างสรรค์ขึ้นแต่ก็อาจหลุดเรื่องง่ายขึ้น
โมเดลที่ดาวน์โหลดครั้งแรกอาจใช้เวลาและพื้นที่พอสมควร ควรตรวจชื่อโมเดล ขนาด ใบอนุญาต และข้อจำกัดจาก Model Card ก่อนใช้งาน
10. OCR: เปลี่ยนภาพตัวหนังสือให้เป็นข้อความ
OCR หรือ Optical Character Recognition เป็นอีกตัวอย่างของงาน AI ที่จับต้องได้ เราให้ภาพใบเสร็จ ป้าย หรือเอกสาร แล้วระบบดึงตัวอักษรออกมา
import cv2
import pytesseract

image = cv2.imread("receipt.png")
gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

# ช่วยให้ตัวอักษรเด่นจากพื้นหลัง
clean = cv2.threshold(
    gray, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU
)[1]

text = pytesseract.image_to_string(clean, lang="eng")
print(text)
โค้ดนี้มีสองทีมทำงานร่วมกัน: OpenCV เตรียมภาพให้สะอาดขึ้น ส่วน Tesseract อ่านตัวอักษร การทำงานจริงอาจต้องหมุนภาพ แก้เงา ตัดเฉพาะบริเวณ และเลือกภาษาให้ถูก
OCR ไม่ได้เข้าใจความหมายของเอกสารโดยอัตโนมัติ มันอาจอ่าน “1” เป็น “I” ได้ ขั้นต่อไปจึงมักมีการตรวจรูปแบบ เช่น ยอดเงินต้องเป็นตัวเลข วันที่ต้องสมเหตุสมผล และข้อมูลสำคัญควรมีคนตรวจในงานที่ผิดพลาดไม่ได้
11. AI อยู่รอบตัวมากกว่าที่คิด
หลายครั้งเราใช้ AI โดยไม่ได้เห็นป้ายเขียนว่า AI
- กล้องมือถือปรับแสงและแยกฉากหลัง
- แผนที่คาดการณ์เวลาเดินทาง
- ร้านค้าแนะนำสินค้า
- ธนาคารตรวจจับธุรกรรมผิดปกติ
- อีเมลกรองสแปมและช่วยเติมประโยค
- แอปเพลงจัด Playlist
- ระบบค้นหาจัดอันดับผลลัพธ์
อย่างไรก็ตาม “อัตโนมัติ” ไม่ได้แปลว่า “AI” เสมอไป เครื่องตั้งเวลารดน้ำที่ทำงานทุกหกโมงเป็น Automation ตามกฎ ส่วนระบบที่ดูความชื้น พยากรณ์อากาศ และปรับเวลาจากข้อมูลอาจมี ML อยู่ข้างใน
เวลาสงสัยให้ถามว่า ระบบทำตามกฎตายตัว หรือเรียนรู้รูปแบบจากข้อมูลเพื่อทำนายและปรับตัว
12. โมเดลก็มีอคติ เพราะข้อมูลไม่ใช่โลกทั้งใบ
โมเดลเรียนจากสิ่งที่เราให้ ถ้าข้อมูลไม่สมดุล มีอคติ หรือสะท้อนอดีตที่ไม่ยุติธรรม โมเดลก็อาจขยายปัญหานั้น
ลองนึกถึงแผนที่เมืองที่พิมพ์ขาดไปหนึ่งย่าน ต่อให้คนขับเก่งแค่ไหน เขาก็ไม่วางแผนผ่านพื้นที่ที่ไม่มีบนแผนที่ โมเดลก็เช่นกัน มันไม่ได้รู้สิ่งที่ไม่ปรากฏในข้อมูลฝึก
คำถามที่ควรถามก่อนใช้ AI จริง:
- ข้อมูลมาจากไหน และได้รับอนุญาตให้ใช้หรือไม่
- กลุ่มผู้ใช้สำคัญครบหรือยัง
- ความผิดพลาดกระทบใครมากที่สุด
- ผู้ใช้รู้หรือไม่ว่ากำลังคุยกับ AI
- มีมนุษย์ตรวจผลในจุดเสี่ยงสูงหรือไม่
- มีวิธีอุทธรณ์หรือแก้ไขเมื่อระบบผิดหรือไม่
- หลังนำไปใช้ เราติดตามคุณภาพและ Data Drift อย่างไร
จริยธรรมไม่ใช่สติกเกอร์ที่แปะท้ายโปรเจกต์ แต่เป็นเข็มขัดนิรภัยที่ต้องออกแบบพร้อมตัวรถ
13. ข้อผิดพลาดยอดนิยมของคนเริ่มทำ ML
เริ่มจากโมเดลก่อนเริ่มจากปัญหา
เห็นโมเดลใหม่แล้วอยากเอามาใช้ทันที คล้ายซื้อสว่านแรงสูงก่อนรู้ว่าจะเจาะอะไร เริ่มจากคำถามและนิยามความสำเร็จก่อนเสมอ
ข้อมูลรั่วจากข้อสอบไปสู่ห้องเรียน
ถ้าใช้ข้อมูล Test ตอนเตรียม Feature หรือเลือกโมเดล ผลประเมินจะสวยเกินจริง ปรากฏการณ์นี้เรียกว่า Data Leakage
เชื่อ Accuracy ค่าเดียว
คะแนนรวมอาจซ่อนความล้มเหลวของกลุ่มเล็กหรือกรณีสำคัญ ต้องเลือก Metric ให้ตรงต้นทุนของความผิดพลาด
คิดว่าโมเดลฝึกเสร็จแล้วจบ
โลกเปลี่ยน พฤติกรรมลูกค้าเปลี่ยน กล้องเปลี่ยน ภาษาเปลี่ยน คุณภาพโมเดลจึงลดลงได้ ต้องติดตามผลหลัง Deploy
เอา Demo ไปใช้เป็นระบบจริงทันที
Notebook ที่รันผ่านหนึ่งครั้งยังไม่ใช่ระบบ Production ของจริงต้องคิดเรื่องความเร็ว ความปลอดภัย Privacy Logging ค่าใช้จ่าย การย้อนกลับ และการดูแลเมื่อโมเดลพัง
14. โปรเจกต์ฝึกมือที่ต่อยอดได้
เลือกโจทย์เล็กที่วัดผลได้ก่อน ไม่ต้องเริ่มจากสร้าง ChatGPT คนเดียวในสุดสัปดาห์
ระดับเริ่มต้น
- ทายราคาบ้านจากข้อมูลตาราง
- จำแนกดอกไม้หรือเลขเขียนมือ
- วิเคราะห์ความรู้สึกของรีวิว
- ใช้โมเดลสำเร็จรูปทายภาพหลายสภาพแสง
ระดับต่อยอด
- ทำ Dashboard เปรียบเทียบผลจริงกับผลทาย
- วิเคราะห์ว่ากลุ่มไหนโมเดลพลาดมากเป็นพิเศษ
- สร้างระบบอ่านข้อความจากใบเสร็จ แล้วตรวจยอดรวม
- เปรียบเทียบโมเดลสองแบบด้วย Metric เดียวกัน
หัวใจของโปรเจกต์ไม่ใช่แค่โชว์ว่ารันได้ แต่ต้องเล่าได้ว่าโจทย์คืออะไร ข้อมูลมาจากไหน วัดอย่างไร พลาดตรงไหน และจะปรับปรุงอะไรต่อ
สรุป: AI ไม่ใช่เวทมนตร์ แต่ก็ทรงพลังกว่าเครื่องคิดเลขมาก
Machine Learning คือการให้ข้อมูลทำหน้าที่เป็นตัวอย่าง เพื่อให้โมเดลค้นหารูปแบบและนำไปทำนายสิ่งใหม่ Deep Learning ขยายแนวคิดนี้ด้วยโครงข่ายหลายชั้น จนจัดการภาพ เสียง และภาษาได้ดีอย่างที่เราเห็นทุกวันนี้
แต่โมเดลไม่ได้ถือความจริงไว้ในมือ มันถือแผนที่ที่วาดจากข้อมูล แผนที่นั้นอาจละเอียด เบี้ยว ล้าสมัย หรือมีพื้นที่หายไป หน้าที่ของคนทำระบบจึงไม่ใช่แค่กด fit() แล้วรอ Accuracy สวย ๆ แต่ต้องถามให้ครบว่าเรียนจากอะไร วัดอย่างไร ใครได้รับผลกระทบ และเมื่อมันผิด เราจะรู้ได้อย่างไร
ถ้าจำอะไรจากบทนี้ได้เพียงประโยคเดียว ให้จำว่า:
AI ที่ดีไม่ได้เริ่มจากโมเดลที่ใหญ่ที่สุด แต่มักเริ่มจากคำถามที่ชัด ข้อมูลที่รับผิดชอบ และวิธีวัดผลที่ซื่อสัตย์