What Are Microservices?
แยกระบบอย่างมีเหตุผล ไม่ใช่แยกเพราะ Diagram ดูแพง
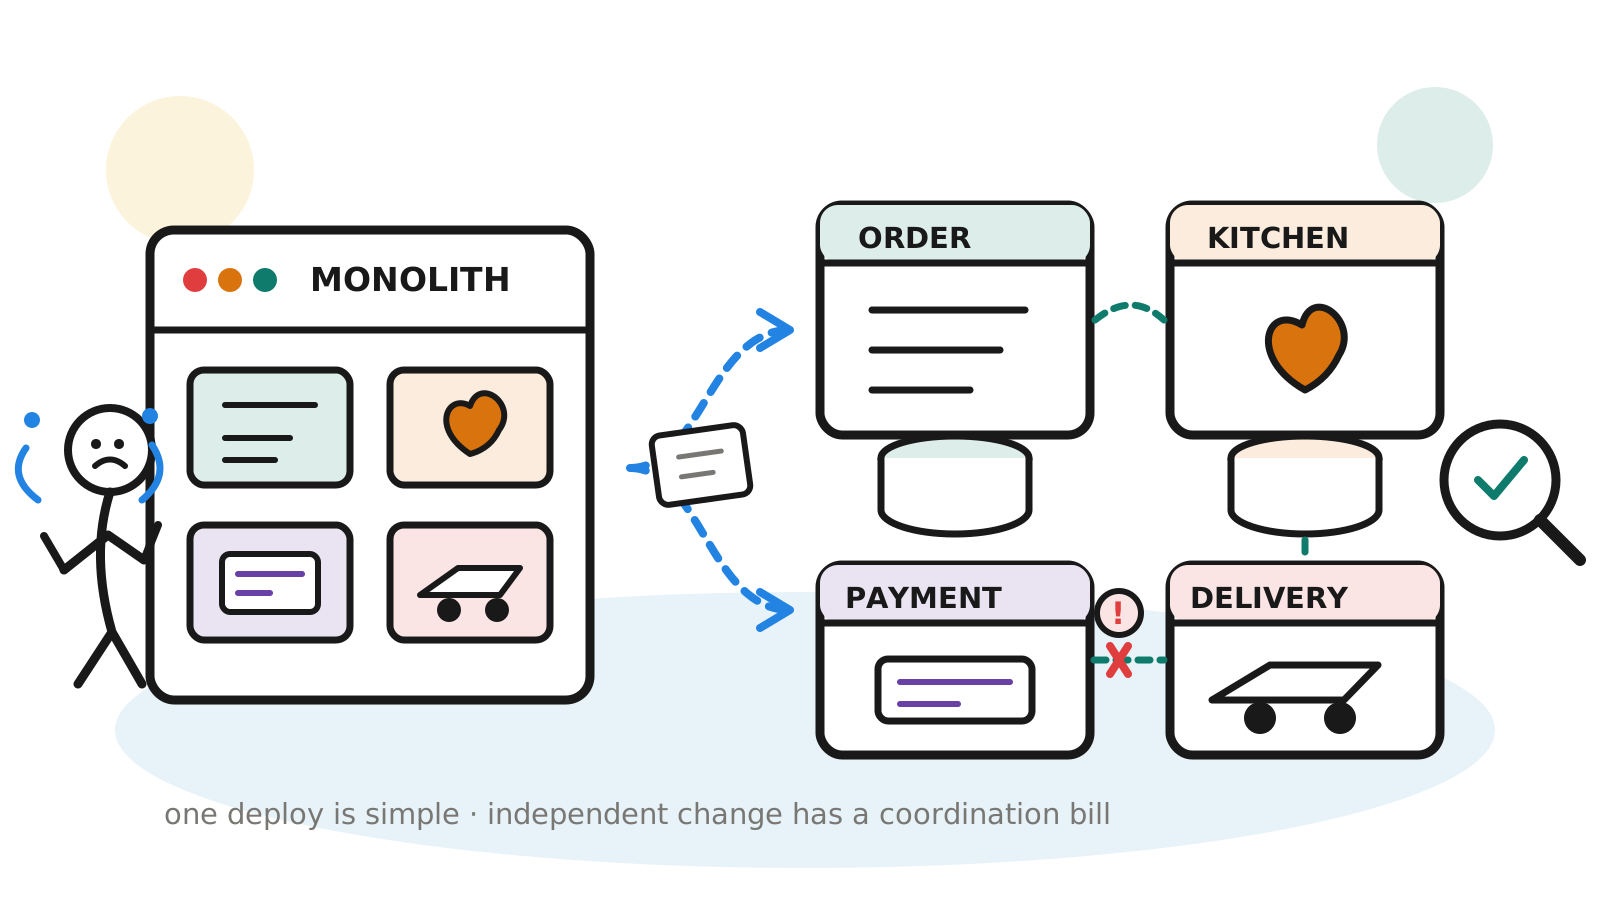
ลองนึกภาพร้านอาหารเล็ก ๆ ที่มีคนอยู่หลังเคาน์เตอร์หนึ่งคน
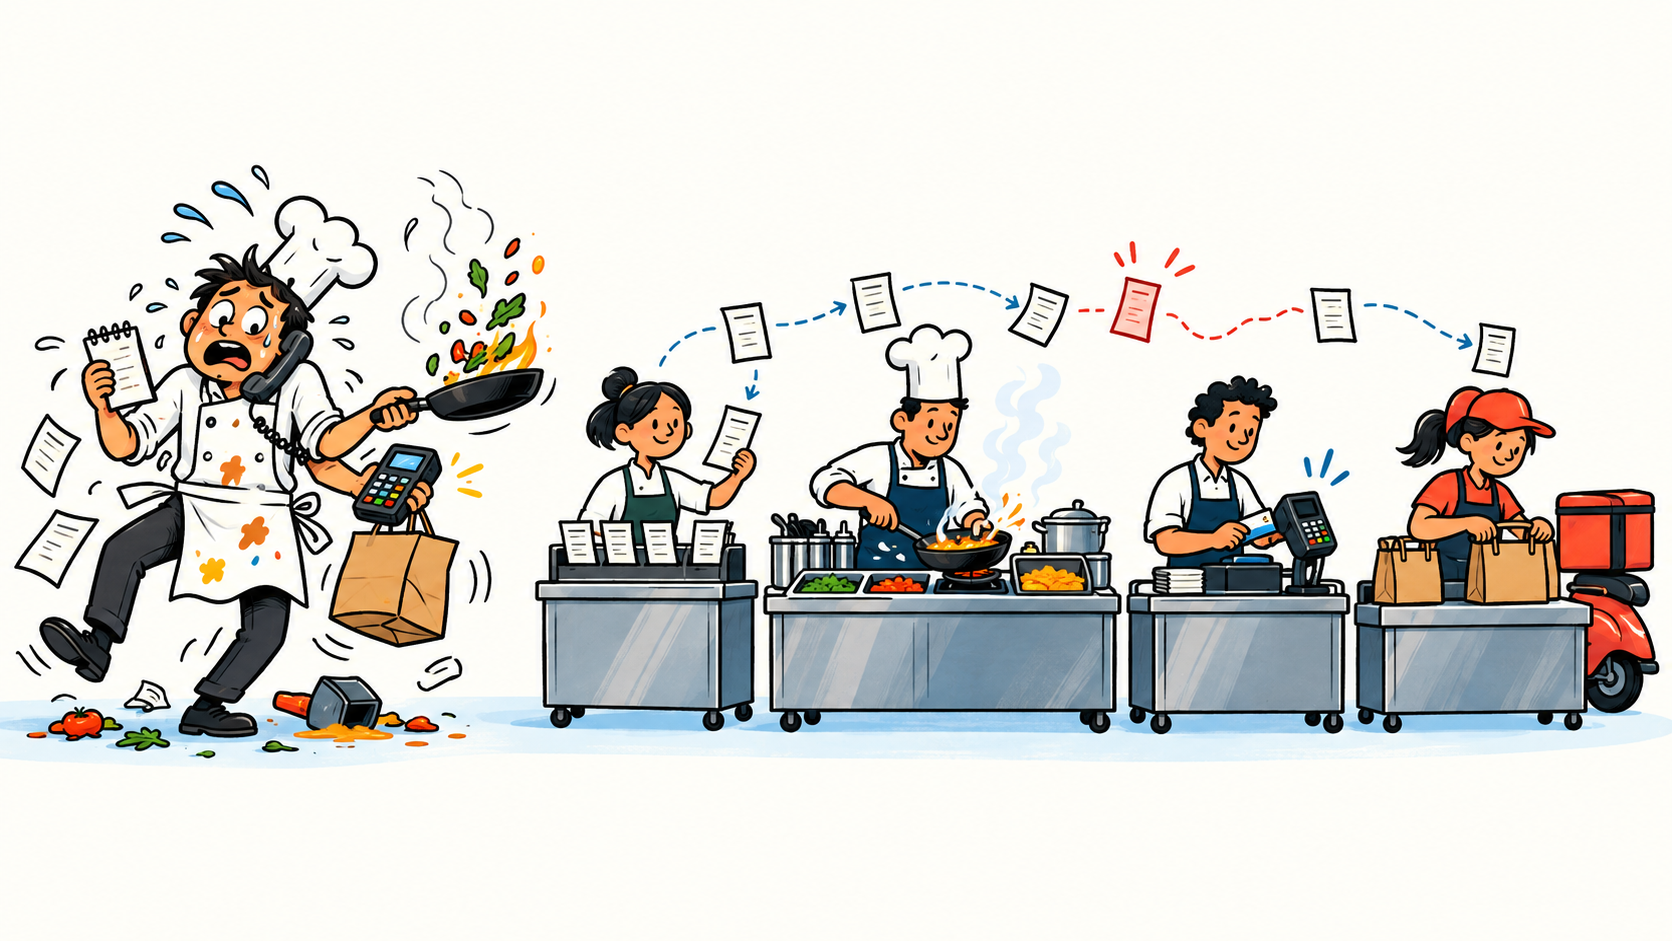
เขารับออเดอร์ ทำอาหาร รับเงิน แพ็กถุง และตะโกนบอกไรเดอร์ว่า “ของโต๊ะเจ็ดได้แล้วครับ” ทุกอย่างอยู่ในหัวคนเดียว เดินสองก้าวก็ถึงกัน และถ้าลูกค้าขอไม่ใส่ผัก เขาไม่ต้องเปิด Ticket เพื่อขออนุมัติจากทีม Vegetable Platform
นี่คือ Monolith ที่ทำงานดี
วันหนึ่งร้านดังขึ้น ออเดอร์เข้าร้อยรายการต่อชั่วโมง คนคนเดิมเริ่มถือโทรศัพท์ด้วยไหล่ ผัดข้าวด้วยมือขวา กดเครื่องคิดเงินด้วยมือซ้าย และใช้พลังจิตตามไรเดอร์ซึ่งยังไม่พบใน Documentation รุ่นปัจจุบัน
ร้านจึงแยกสถานีรับออเดอร์ ครัว การเงิน และจัดส่ง แต่ละสถานีมีคนและอุปกรณ์ของตัวเอง เปลี่ยนวิธีทำงานบางส่วนได้โดยไม่ต้องปิดทั้งร้าน
ฟังดูเหมือนชีวิตดีขึ้น แต่ตอนนี้ออเดอร์หนึ่งใบต้องเดินทางผ่านหลายสถานี ถ้ากระดาษหายกลางทาง ลูกค้าอาจจ่ายเงินแล้วแต่ครัวไม่รู้ว่าต้องทำอะไร ถ้าครัวช้า ฝ่ายจัดส่งก็ยืนมองถุงเปล่าอย่างมืออาชีพ
ยินดีต้อนรับสู่ Microservices ครับ
คอร์สนี้จะไม่พาเริ่มจาก Kubernetes, Service Mesh หรือ YAML ที่ยาวพอใช้เป็นผ้าพันคอ เราจะเริ่มจากปัญหาที่ Microservices ตั้งใจแก้ แล้วค่อยดูว่าต้องรับภาระอะไรกลับมาบ้าง
เป้าหมายหลังอ่านจบคือ คุณควรตอบคำถามเหล่านี้ได้
- Microservice ต่างจาก API หลายตัวอย่างไร
- ควรแบ่ง Service ตรงไหน และอะไรควรอยู่ด้วยกัน
- ทำไมแต่ละ Service จึงควรเป็นเจ้าของข้อมูลของตัวเอง
- เวลา Network หรือ Service ข้างบ้านพัง ระบบควรทำอย่างไร
- Distributed transaction, Saga และ Outbox เข้ามาเกี่ยวเมื่อไร
- ต้องมี Observability, Deployment และทีมแบบไหนก่อนขึ้น Production
- ระบบของเราต้องใช้ Microservices จริง หรือ Modular Monolith ก็เพียงพอ
1. Microservice ไม่ได้แปลว่า “โปรแกรมตัวเล็ก”
คำว่า Micro ทำให้หลายทีมเริ่มผิดจุด เราเปิด Repository แล้วนับบรรทัด ถ้า Service ไหนเกิน 2,000 บรรทัดก็รู้สึกผิดเหมือนกินของหวานหลังสามทุ่ม
ความเล็กไม่ใช่แก่นของเรื่องครับ ความเป็นอิสระต่างหากที่สำคัญ
Microservice คือส่วนหนึ่งของระบบที่โดยทั่วไปมีคุณสมบัติแบบนี้
- รับผิดชอบความสามารถทางธุรกิจที่ชัดเจน
- มี Contract สำหรับคุยกับส่วนอื่น เช่น API หรือ Event
- Deploy และเปลี่ยนแปลงได้โดยไม่ต้องลากทั้งระบบไปพร้อมกัน
- เป็นเจ้าของ Logic และข้อมูลในขอบเขตของตัวเอง
- มีทีมที่รับผิดชอบตั้งแต่สร้างจนถึงดูแลตอนใช้งานจริง
Microsoft อธิบาย Microservices ว่าเป็น Component ที่เล็ก เป็นอิสระ และเชื่อมกันแบบหลวม แต่คำว่า “เล็ก” ต้องอ่านคู่กับ “ทีมเล็กดูแลได้” และ “Deploy แยกได้” ไม่ใช่เล็กจนหนึ่ง Request ต้องโทรหา 38 Service เพื่อถามชื่อผู้ใช้
API หลายตัว ยังไม่แปลว่าเป็น Microservices
เราสามารถมี API 20 ตัวอยู่ใน Application เดียวและ Deploy พร้อมกันได้ นั่นยังเป็น Monolith ที่มีหลาย Endpoint ซึ่งไม่ใช่เรื่องผิด
ในทางกลับกัน เราอาจมี Container 20 ใบ แต่ทุกใบใช้ Database schema เดียวกัน ต้อง Release พร้อมกัน และถ้าแก้ Customer table ต้องประชุม 7 ทีม แบบนี้เรียกว่า Distributed Monolith ได้เต็มปาก
มันเก็บความยุ่งยากของ Monolith ไว้ครบ แล้วสมัครความยุ่งยากของ Distributed System เพิ่มเข้ามา เพราะบางองค์กรเชื่อเรื่อง Work-Life Integration อย่างจริงจัง
ภาพจำ: Microservices ไม่ได้วัดจากจำนวนกล่องใน Diagram แต่วัดจากว่ากล่องเหล่านั้นเปลี่ยนและล้มแยกกันได้จริงแค่ไหน
2. ก่อนด่า Monolith ลองดูว่ามันทำอะไรให้เราบ้าง
Monolith คือ Application ที่ส่วนต่าง ๆ Build และ Deploy เป็นหน่วยเดียว มันอาจจัดโค้ดดีมาก มี Module ชัด ทดสอบง่าย และรองรับผู้ใช้จำนวนมากได้
ข้อดีของ Monolith ได้แก่
- เริ่มพัฒนาและรันในเครื่องง่าย
- เรียก Function กันตรง ๆ ไม่เสียเวลาเดินทางผ่าน Network
- Transaction ใน Database เดียวจัดการง่ายกว่า
- Debug ด้วย Stack trace เดียวได้บ่อย
- Deploy หน่วยเดียว ไม่ต้องตาม Compatibility หลายเวอร์ชัน
- ทีมเล็กมองเห็นระบบทั้งก้อนได้
คำว่า Monolith จึงไม่ได้แปลว่าโค้ดแย่ มันเป็นรูปแบบการ Deploy รูปแบบหนึ่ง ปัญหาเกิดเมื่อระบบโตจนทุกการเปลี่ยนต้องชนกัน ทุกทีมรอกัน และ Module ข้างในพัวพันเหมือนสายชาร์จในลิ้นชัก
Modular Monolith ทางเลือกที่มักถูกข้ามเพราะชื่อไม่หวือหวา
Modular Monolith ยัง Deploy เป็น Application เดียว แต่ข้างในแบ่ง Module ชัดเจน เช่น Order, Payment และ Delivery แต่ละ Module ซ่อนรายละเอียดของตัวเองและคุยผ่าน Interface ที่กำหนด
เราได้ Boundary และวินัยทางสถาปัตยกรรมจำนวนมาก โดยยังไม่ต้องเสียภาษี Network, Distributed tracing และ Eventual consistency
ถ้าทีมยังมีไม่กี่คน Domain ยังเปลี่ยนเร็ว หรือเรายังไม่รู้ว่า Boundary อยู่ตรงไหน Modular Monolith มักเป็นจุดเริ่มที่ฉลาดกว่า การเริ่มด้วย Microservices ในวันที่ยังไม่เข้าใจธุรกิจ เท่ากับใช้เลื่อยตัดบ้านก่อนรู้ว่าห้องน้ำอยู่ตรงไหน
สามรูปแบบที่ต้องแยกให้ออก
| รูปแบบ | Deploy | Data | เหมาะกับ |
|---|---|---|---|
| Monolith | หน่วยเดียว | มักเป็นฐานเดียว | ระบบเริ่มต้น ทีมเล็ก งานที่ต้องการความเรียบง่าย |
| Modular Monolith | หน่วยเดียว แต่แบ่ง Module ชัด | แยก Ownership ในเชิง Logic ได้ | Domain กำลังโต แต่อิสระในการ Deploy ยังไม่จำเป็น |
| Microservices | หลาย Service แยก Deploy | แต่ละ Service เป็นเจ้าของข้อมูล | หลายทีม ต้องเปลี่ยนหรือ Scale ต่างจังหวะ และมีความพร้อมด้าน Operation |
3. เหตุผลที่ดีในการใช้ Microservices
Microservices มีต้นทุนสูง เหตุผลที่เลือกใช้จึงควรหนักพอจ่ายบิล
ทีมต้องส่งงานคนละจังหวะ
ถ้าทีม Order ต้อง Release ทุกวัน แต่ทีม Billing เปลี่ยนไตรมาสละครั้ง การผูกทั้งสองเข้ากับ Release train เดียวอาจทำให้ฝ่ายหนึ่งต้องรออีกฝ่ายโดยไม่จำเป็น
Service ที่ Deploy แยกกันช่วยให้ทีมตัดสินใจและส่งของได้เอง ตราบใดที่ยังรักษา Contract กับเพื่อนบ้าน
ส่วนหนึ่งต้อง Scale ไม่เหมือนส่วนอื่น
ระบบขายบัตรอาจมี Traffic หนักที่ Search และ Queue ตอนเปิดขาย แต่หน้า Admin แทบไม่มีใครใช้ เราอาจ Scale เฉพาะส่วนที่ร้อนแทนยกทั้ง Application ขึ้นมาหลายชุด
ต้องแยก Fault หรือความเสี่ยง
งานสร้าง Report หนัก ๆ ไม่ควรลาก Checkout หลักลงไปด้วย ถ้า Boundary ดี Failure ของงานหนึ่งจะถูกกักไว้ในขอบเขตของมันได้ง่ายขึ้น
คำว่า “ง่ายขึ้น” สำคัญ เพราะ Service แยกไม่ได้แปลว่า Fault isolation เกิดเอง ถ้า Checkout เรียก Report แบบ Synchronous และรอไม่มีกำหนด ทั้งคู่ก็ยังลงเรือลำเดียวกัน เพียงแต่นั่งคนละห้อง
Domain ใหญ่และมีหลายทีมเป็นเจ้าของ
เมื่อธุรกิจมีส่วนที่ใช้ภาษา กฎ และจังหวะเปลี่ยนต่างกัน เช่น Catalog, Pricing, Order และ Fulfillment การแยกตาม Bounded Context ช่วยให้แต่ละทีมดูแล Model ของตัวเองโดยไม่ต้องยัดความหมายทุกอย่างลง Entity กลางชื่อ CommonMasterDataFinalV3
ข้อกำหนดด้านเทคโนโลยีหรือ Compliance ต่างกันจริง
บางส่วนต้องแยกข้อมูลเพื่อ Compliance บางส่วนต้องใช้ Runtime หรือ Storage ต่างกันมาก การแยก Service อาจช่วยได้ แต่คำว่า Polyglot ไม่ใช่บัตรบุฟเฟต์ภาษาโปรแกรม ทีมไม่จำเป็นต้องใช้ Go, Rust, Java และภาษาที่เพิ่งประกาศเมื่อเช้าเพียงเพื่อพิสูจน์ว่า Architecture เปิดกว้าง
4. เหตุผลที่ยังไม่ควรใช้
Microservices อาจยังไม่เหมาะ ถ้าเราอยู่ในสถานการณ์เหล่านี้
- Product ยังหาทิศทางและ Domain เปลี่ยนทุกสัปดาห์
- ทีมเล็กจนทุกคนดูทุกอย่างอยู่แล้ว
- ยังไม่มี Automated test, CI/CD หรือระบบ Monitoring ที่เชื่อถือได้
- ทุก Feature ต้องแก้แทบทุก Service พร้อมกัน
- Transaction ส่วนใหญ่ต้องการ Strong consistency ข้ามขอบเขต
- Traffic และ Scale ยังไม่มีปัญหาจริง
- เป้าหมายคือ “บริษัทอื่นมี เราก็ควรมี”
การเลือก Monolith ไม่ใช่การสอบตกวิชา Architecture บางครั้งมันคือการเลือกไม่เช่ารถบรรทุกสิบคันเพื่อย้ายเก้าอี้ตัวเดียว
กฎง่าย ๆ: ถ้ายังบอกไม่ได้ว่าเราต้องการอิสระด้านใด อย่าเพิ่งซื้อความซับซ้อนเพื่อแลกกับคำว่า Independent
5. Boundary ของ Service อยู่ตรงไหน
นี่คือส่วนที่ยากที่สุด ไม่มีคำสั่ง generate-microservices --correct-boundary เพราะถ้ามี บริษัทที่ขาย Workshop DDD จำนวนมากคงต้องเปลี่ยนอาชีพ
แนวทางที่ดีคือแบ่งตาม Business capability หรือความสามารถของธุรกิจ ไม่ใช่แบ่งตามชั้นเทคนิค
แบ่งแบบชั้นเทคนิค มักได้การโทรข้ามบ้านตลอดวัน
ตัวอย่างที่น่ากังวล
Frontend Service
Business Logic Service
Data Access Service
Email Service
Validation Service
ทุก Feature ต้องวิ่งผ่านหลาย Service และหลายทีม การเปลี่ยนกฎธุรกิจหนึ่งข้ออาจต้อง Deploy พร้อมกันหมด เราได้ Diagram แนวนอนสวยมาก แลกกับการทำงานจริงที่ต้องส่งหนังสือราชการข้ามโต๊ะ
แบ่งตามความสามารถทางธุรกิจ
สำหรับร้านส่งอาหาร เราอาจพบ Context แบบนี้
- Ordering รับและจัดการวงจรชีวิตออเดอร์
- Payment อนุมัติ เก็บเงิน คืนเงิน และเก็บประวัติทางการเงิน
- Kitchen จัดคิวและสถานะการทำอาหาร
- Delivery จับคู่ไรเดอร์และติดตามการจัดส่ง
แต่ละ Context มีภาษาและกฎของตัวเอง คำว่า status ใน Order ไม่จำเป็นต้องใช้ Enum ชุดเดียวกับ Delivery เพราะ PAID มีความหมายกับ Order แต่ไม่ได้บอกว่าไรเดอร์ถึงร้านหรือยัง
แบบทดสอบ Boundary ห้าข้อ
ก่อนแยก Service ลองถาม
- เปลี่ยนพร้อมกันบ่อยไหม ถ้าสองส่วนต้องแก้และ Deploy คู่กันเสมอ อาจควรอยู่ด้วยกัน
- คุยกันถี่แค่ไหน ถ้าทุก Request ต้องโทรกลับไปกลับมาหลายรอบ Boundary อาจผ่ากลางบทสนทนา
- ใครเป็นเจ้าของข้อมูล ต้องตอบได้ว่า Fact ชิ้นนี้มี Source of truth อยู่ที่ใด
- ล้มแยกกันได้ไหม ถ้าส่วนหนึ่งล้ม อีกส่วนควรทำงานต่อหรือ Degrade อย่างไร
- ทีมดูแลได้จริงไหม Service boundary ที่ไม่มี Ownership มักกลายเป็นบ้านร้างพร้อม Pager
Microsoft แนะนำให้ใช้ Domain analysis หา Bounded Context และเตือนว่าไม่มีวิธีเชิงกลที่ผลิต Boundary ถูกต้องออกมาได้ Boundary จึงเป็นสมมติฐานที่ต้องปรับเมื่อเราเรียนรู้ธุรกิจมากขึ้น
ถ้าคุยกันจ้อไม่หยุด ลองจับกลับมาอยู่บ้านเดียวกัน
สอง Service ที่แลกข้อมูลกันทุกไม่กี่ Millisecond ใช้ข้อมูลแทบชุดเดียวกัน และ Release พร้อมกันตลอด อาจเป็นสัญญาณว่าเราแยกละเอียดเกินไป
Microservice ไม่ใช่หมู่บ้านจัดสรรที่มีกฎว่าหนึ่ง Function ต้องได้บ้านหนึ่งหลัง บาง Capability ใหญ่พอจะอยู่ร่วมกันโดยยัง Cohesive และดูแลง่ายกว่า
6. Data Ownership จุดที่ Microservices เริ่มจริงจัง
กฎสำคัญคือ Service เป็นเจ้าของข้อมูลในขอบเขตของตัวเอง Service อื่นอ่านหรือแก้ผ่าน Contract ไม่ใช่ต่อ Database เข้าไปหยิบ Table ตามสบาย
สมมติ Payment เป็นเจ้าของ Transaction ทางการเงิน Ordering ไม่ควรเขียน UPDATE payment_transactions ตรง ๆ แม้สิทธิ์ Database จะเปิดไว้และ Deadline จะยืนถือไม้เรียวอยู่ข้างหลัง
เหตุผลคือ Schema ภายในเป็นรายละเอียดของ Payment ถ้า Ordering อาศัย Table ตรง ๆ Payment จะเปลี่ยน Schema ไม่ได้โดยไม่เสี่ยงทำคนอื่นพัง ความเป็นอิสระก็หายไปตรงนั้น
Database per Service ไม่ได้บังคับว่าต้องซื้อ Server แยกทุกก้อน
แต่ละ Service อาจใช้ Database server เดียวกันได้ในช่วงเริ่มต้น ตราบใดที่แยก Schema, Credential และ Ownership ชัดเจน สิ่งที่ต้องห้ามคือหลาย Service อ่านเขียน Table ชุดเดียวกันโดยไม่มีเจ้าภาพ
การแยก Physical instance เป็นอีกการตัดสินใจหนึ่ง ซึ่งเกี่ยวกับ Scale, Fault isolation, Compliance และ Cost อย่าซื้อ Database cluster ห้าชุดเพราะ Diagram มีห้าสี แล้วพบทีหลังว่า Bill มีสีเดียวคือแดง
ข้อมูลซ้ำไม่ใช่บาปเสมอไป
Delivery อาจเก็บชื่อและเบอร์โทรที่จำเป็นสำหรับงานส่ง โดย Customer Service ยังเป็น Source of truth การทำสำเนาบางส่วนช่วยลดการเรียกข้าม Service แต่ต้องยอมรับว่าข้อมูลอาจตามกันไม่ทันช่วงสั้น ๆ
นี่คือ Eventual consistency ข้อมูลในระบบจะไปถึงสถานะสอดคล้องกันในที่สุด ไม่ได้แปลว่า “เดี๋ยวสักวันคงถูกเอง” เราต้องออกแบบว่า
- ช้าสุดได้กี่วินาทีหรือนาที
- ระหว่างนั้นผู้ใช้เห็นอะไร
- ถ้า Event หายหรือซ้ำจะทำอย่างไร
- ใครเป็น Source of truth
- มีวิธี Reconcile หรือ Replay ข้อมูลไหม
7. Service คุยกันแบบไหน
การสื่อสารหลักมีสองแบบ และระบบจริงมักใช้ทั้งคู่
Synchronous ขอแล้วรอคำตอบ
ตัวอย่างคือ HTTP/REST หรือ gRPC
Ordering ขอ Payment: ช่วยอนุมัติเงิน 450 บาท
Payment ตอบ: สำเร็จ / ไม่สำเร็จ
ข้อดีคือเข้าใจง่าย ผู้เรียกได้คำตอบทันที เหมาะกับข้อมูลที่ต้องใช้ตัดสินใจก่อนตอบผู้ใช้
ข้อเสียคือผู้เรียกผูก Availability และ Latency กับผู้ถูกเรียก ถ้า A รอ B, B รอ C และ C กำลังรอ Database ล้าง Cache ทุกคนก็ได้ฝึกสมาธิพร้อมกัน
Asynchronous ส่ง Message แล้วไปทำงานต่อ
ตัวอย่างคือ Queue หรือ Event broker
Ordering บันทึกออเดอร์
Ordering ส่ง event: OrderPlaced
Kitchen และ Delivery รับ event ไปทำงานของตัวเอง
ข้อดีคือแยกจังหวะงาน รองรับ Spike และลดการผูก Availability กันตรง ๆ
ข้อเสียคือ Flow มองยากขึ้น ผลลัพธ์อาจมาทีหลัง Message อาจซ้ำ และการ Debug ต้องตามรอยข้ามหลายระบบ
เลือกด้วยคำถาม ไม่ใช่ศาสนา
ใช้ Synchronous เมื่อผู้ใช้หรือขั้นตอนถัดไปต้องการคำตอบทันที และจำนวน Dependency อยู่ในระดับควบคุมได้
ใช้ Asynchronous เมื่อผู้ส่งไม่จำเป็นต้องรอ งานรับ Spike ได้ ต้องกระจายให้หลาย Consumer หรืออยากให้ปลายทางล่มชั่วคราวโดย Message ยังรออยู่
อย่าเปลี่ยนทุกอย่างเป็น Event เพียงเพราะ Event-driven ฟังดูเหมือนระบบกำลังมีชีวิต บางครั้ง Function call ที่ชัดเจนก็เป็นเทคโนโลยีล้ำหน้าพอสำหรับโจทย์แล้ว
ตั้งชื่อ Event ให้บอกสิ่งที่เกิดขึ้น
ชอบ:
OrderPlaced
PaymentAuthorized
DeliveryAssigned
ควรระวัง:
OrderUpdated
DataChanged
ProcessCompleted
Event ควรสื่อ Business fact ที่เกิดขึ้นแล้ว ไม่ใช่ถุงดำชื่อกว้าง ๆ ให้ Consumer เปิดดูเองว่าเจ้าของบ้านทิ้งอะไรมา
8. Network ทำให้คำสั่งธรรมดากลายเป็นคำถามเชิงปรัชญา
ใน Monolith ถ้าเรียก Function แล้ว Error เรามักรู้ว่ามันล้ม แต่พอข้าม Network จะมีสถานการณ์แบบนี้
- Ordering ส่งคำขอเก็บเงิน
- Payment เก็บเงินสำเร็จ
- Network ขาดก่อน Response กลับ
- Ordering เห็น Timeout
คำถามคือ เงินถูกเก็บหรือยัง
คำตอบคือ “อาจจะ” ซึ่งเป็นคำที่ฝ่ายการเงินชอบน้อยพอ ๆ กับ Auditor
Timeout ต้องมีเสมอ
การรอไม่มีกำหนดทำให้ Resource ค้างและ Failure ลาม ตั้ง Timeout ตามพฤติกรรมจริงและ Budget ของ Request ทั้งเส้นทาง ไม่ใช่ตั้งทุก Service ไว้ 30 วินาทีแล้วต่อกันสิบชั้น
Retry เฉพาะเรื่องที่ควร Retry
Network สะดุดชั่วคราวอาจ Retry ได้ แต่ Validation error หรือเลขบัตรผิด Retry อีก 300 ครั้งก็ไม่ได้ทำให้ข้อมูลมีบุคลิกดีขึ้น
ใช้ Backoff และ Jitter เพื่อไม่ให้ทุก Instance Retry พร้อมกันเหมือนคนทั้งคอนเสิร์ตวิ่งออกประตูเดียว
Idempotency ป้องกันงานซ้ำ
Operation แบบ Idempotent รับ Request เดิมซ้ำแล้วไม่สร้างผลกระทบเพิ่ม เช่น Payment ใช้ idempotency_key เดิมแล้วคืนผล Transaction เดิม แทนเก็บเงินใหม่ทุกครั้ง
Message consumer ก็ควรรับมือ Message ซ้ำ โดยบันทึก Message ID ที่เคยทำแล้ว หรือออกแบบ Operation ให้ทำซ้ำได้อย่างปลอดภัย
Circuit Breaker หยุดโทรหาคนที่ไม่รับสาย
ถ้า Service ปลายทางพังต่อเนื่อง Circuit breaker จะหยุดเรียกชั่วคราวและ Fail fast จากนั้นค่อยทดลองใหม่เมื่อครบเวลา วิธีนี้ลดการรอและป้องกัน Failure ลาม
Circuit breaker ไม่ได้ซ่อม Service ให้ มันเพียงห้ามระบบกดโทรซ้ำทุก 20 Millisecond ด้วยความหวังว่าปลายทางจะประทับใจในความพยายาม
Bulkhead แยกช่องความเสียหาย
จำกัด Thread, Connection หรือ Queue ของ Dependency แต่ละกลุ่ม ถ้า Report Service ช้า มันจะกิน Resource ได้เฉพาะช่องของตัวเอง ไม่ลาก Payment ลงไปด้วย แนวคิดมาจากผนังกั้นห้องเรือ ซึ่งทำให้เรือไม่จมทั้งลำเมื่อน้ำเข้าบางส่วน
9. Transaction ที่ข้าม Service ไม่มีปุ่ม Undo กลางจักรวาล
ใน Database เดียว เราใช้ Transaction ครอบหลายคำสั่งแล้ว Commit หรือ Rollback พร้อมกันได้ แต่เมื่อ Order, Payment และ Delivery มี Database ของตัวเอง เราไม่ควรหวังว่า Transaction แบบเดิมจะครอบทุกอย่างได้ง่าย
Saga แบ่งงานใหญ่เป็น Local transaction
ตัวอย่าง Saga สำหรับสั่งอาหาร
1. Order สร้างออเดอร์สถานะ PENDING
2. Payment เก็บเงิน
3. Kitchen รับงาน
4. Delivery หาไรเดอร์
5. Order เปลี่ยนเป็น CONFIRMED
ถ้าขั้นสามล้ม เราต้องมี Compensating action เช่นคืนเงินและยกเลิกออเดอร์ มันไม่ใช่การย้อนเวลา Database แต่เป็นธุรกิจทำรายการใหม่เพื่อชดเชยสิ่งที่เกิดไปแล้ว
Saga มีสองแนวทาง
- Choreography แต่ละ Service ฟัง Event และทำขั้นถัดไป ไม่มีผู้ควบคุมกลาง เหมาะกับ Flow ที่ไม่ซับซ้อนมาก
- Orchestration มีตัวประสานงานรู้ลำดับและสั่งแต่ละ Service เหมาะกับ Flow ที่ต้องมองสถานะรวมและจัดการทางแยกหลายแบบ
ไม่มีแบบไหนฟรี Choreography อาจกลายเป็นงานเต้นที่ไม่มีใครรู้ว่าใครเปิดเพลง ส่วน Orchestrator อาจโตเป็นสมองกลางที่รู้ทุกอย่างจน Service อื่นเหลือเพียงมือไม้
Transactional Outbox แก้ปัญหาเขียน Database สำเร็จแต่ส่ง Event ไม่สำเร็จ
ให้ Service บันทึก Business data และ Event ลง Outbox table ใน Transaction เดียวกัน จากนั้น Worker อีกตัวค่อยอ่าน Outbox แล้วส่งไป Broker
BEGIN
  INSERT INTO orders (...)
  INSERT INTO outbox (event_id, type, payload, ...)
COMMIT

Outbox publisher อ่านรายการที่ยังไม่ส่ง แล้ว publish
Publisher อาจส่ง Event ซ้ำหลัง Crash ได้ Consumer จึงยังต้อง Idempotent ตามเอกสาร AWS ที่อธิบาย Transactional outbox ไว้ตรงประเด็นมาก
คำสัญญา “Exactly once” มักมีขอบเขต เช่น Exactly once ใน Broker หรือใน Transaction ชุดหนึ่ง แต่ End-to-end ระหว่างหลายระบบยังควรออกแบบรับ Duplicate แทนการแขวนความหวังไว้กับโบรชัวร์
10. API Gateway ประตูหน้า ไม่ใช่รัฐมนตรีทุกกระทรวง
Client ไม่ควรรู้ว่าหลังบ้านมี Service กี่ตัวหรือย้ายบ้านเมื่อไร API Gateway ให้ Endpoint กลาง แล้วจัดการเรื่องอย่าง Routing, TLS termination, Authentication, Rate limiting หรือ Request aggregation ตามความจำเป็น
แต่ไม่ควรยัด Business rule ทั้งหมดไว้ใน Gateway เพราะมันจะกลายเป็น Monolith ตัวใหม่ตรงหน้าบ้าน ทุก Service เป็นอิสระ ยกเว้นตอนอยากทำอะไรจริงซึ่งต้องขออนุญาตด่านเดียว
ใน Kubernetes ปัจจุบัน Gateway API มี Resource หลักที่ Stable หลายชนิด เช่น GatewayClass, Gateway และ HTTPRoute ช่วยแยกบทบาทคนดูแล Infrastructure กับทีม Application ชัดกว่าการอัดความสามารถทุกอย่างใน Annotation ของ Ingress แต่การใช้ Kubernetes หรือ Gateway API ไม่ใช่เงื่อนไขว่าเรามี Microservices
เรารัน Microservices บน VM, Container platform หรือ Serverless ได้ Architecture กับ Deployment platform เกี่ยวข้องกัน แต่ไม่ใช่สิ่งเดียวกัน
11. Observability จาก “เครื่องไหนพัง” ไปสู่ “Request นี้หลงตรงไหน”
ระบบหนึ่งก้อนมี Log ชุดเดียวก็ยังพอไล่ได้ พอ Request เดินผ่าน Gateway, Order, Payment และ Delivery การเปิด Log ทีละ Service แล้วเทียบเวลาเหมือนดูภาพยนตร์ที่แยกฉากใส่คนละโทรศัพท์
Observability ที่จำเป็นมีอย่างน้อย
- Logs บันทึกเหตุการณ์พร้อมข้อมูลเชิงโครงสร้าง
- Metrics ตัวเลขตามเวลา เช่น Error rate, Latency, Throughput และ Saturation
- Traces เส้นทางของ Request ผ่านหลาย Service
OpenTelemetry เป็นมาตรฐานเปิดสำหรับสร้าง เก็บ และส่ง Telemetry โดยเน้น Signals อย่าง Traces, Metrics และ Logs สิ่งสำคัญสำหรับ Microservices คือ Context propagation เพื่อให้ trace_id เดียวตาม Request ข้าม Service ได้
Log ที่ใช้งานได้ควรมี Context
{
  "level": "error",
  "service": "payment",
  "trace_id": "8f4...",
  "order_id": "ord_123",
  "event": "payment_authorization_failed",
  "reason": "issuer_timeout"
}
ข้อความ something went wrong อาจซื่อสัตย์ทางอารมณ์ แต่ช่วยคน On-call ได้น้อย
วัดจากมุมผู้ใช้
CPU ของทุก Service อาจเขียวหมด แต่ลูกค้าจ่ายเงินไม่ได้ จึงต้องมี SLI/SLO ที่สะท้อน Journey เช่น
- สัดส่วนออเดอร์ที่สร้างสำเร็จ
- Latency ของ Checkout ตั้งแต่ Client ถึงคำตอบ
- ระยะเวลาตั้งแต่รับเงินจนร้านเห็นออเดอร์
- จำนวนออเดอร์ค้างในสถานะระหว่างทาง
Dashboard ที่มีกราฟ 80 แผ่นแต่ตอบไม่ได้ว่าลูกค้าซื้อของได้ไหม เป็นงานศิลปะร่วมสมัยประเภทหนึ่งครับ
12. Independent Deployment ต้องมีวินัยมากกว่าแยก Repository
คำว่า Deploy แยกได้จะจริงก็ต่อเมื่อทีมทำสิ่งเหล่านี้ได้
Contract ต้องเข้ากันข้ามเวอร์ชัน
Provider ไม่ควรเปลี่ยน Field หรือความหมายแล้วบังคับ Consumer ทุกตัว Deploy พร้อมกัน ใช้หลัก Backward compatibility เช่นเพิ่ม Field แบบ Optional ก่อน ย้าย Consumer แล้วค่อยลบของเก่า
ใช้ OpenAPI, Protobuf หรือ Event schema ช่วยอธิบาย Contract และตรวจ Breaking change ได้ แต่ไฟล์ Schema ไม่ช่วยถ้าทีมแก้แล้วไม่รัน Check
Test หลายระดับ
- Unit test ตรวจ Logic ใน Service
- Integration test ตรวจ Database, Broker และ Adapter จริงในขอบเขต
- Contract test ตรวจความคาดหวังระหว่าง Provider กับ Consumer
- End-to-end test เก็บไว้กับ Journey สำคัญ ไม่จำเป็นต้องจำลองจักรวาลทุกเส้นทาง
Deployment ต้องย้อนกลับหรือเดินหน้าแก้ได้
มี Health check, Readiness, Progressive rollout และ Feature flag ตามความเหมาะสม Database migration ต้องรองรับช่วงที่ Code เก่าและใหม่ทำงานพร้อมกัน
ถ้า Deploy แยกได้แต่ทุกครั้งต้องนัดทุกทีมเข้าห้อง War room เรามี Independent Pipeline แต่ยังไม่มี Independent Delivery
13. ทีมและ Platform คือส่วนหนึ่งของ Architecture
Microservices กระจายทั้ง Code และความรับผิดชอบ ถ้าองค์กรยังต้องเปิด Ticket ให้ทีมกลางทุกครั้งเพื่อสร้าง Queue, Dashboard หรือ Secret ความเร็วที่หวังไว้อาจหายไปในระบบคิวอนุมัติ
Platform ที่ดีควรมีทางมาตรฐานสำหรับงานซ้ำ ๆ เช่น
- สร้าง Service และ Pipeline จาก Template ที่ดูแลจริง
- จัดการ Configuration กับ Secrets
- Logging, Metrics และ Tracing
- Service discovery และ Traffic policy
- Security scanning, Artifact registry และ Deployment
- Runbook, Alert และ Ownership metadata
คำว่า Platform ไม่จำเป็นต้องแปลว่าสร้าง Portal ใหญ่ก่อนมีผู้ใช้หนึ่งคน เริ่มจาก Golden path ที่ลดงานซ้ำได้จริง แล้วค่อยขยายตาม Pain ของทีม
You build it, you run it ต้องมีความสามารถและอำนาจคู่กัน
ทีมที่ On-call ต้องเห็น Telemetry แก้ Config และ Deploy ได้ตามสิทธิ์ ถ้าให้รับผิดชอบแต่ไม่มีเครื่องมือ นั่นไม่ใช่ Ownership แต่เป็นการมอบ Pager พร้อมคำอวยพร
14. Security พื้นที่โจมตีเพิ่มตามจำนวนประตู
เมื่อมี Service มากขึ้น เรามี Endpoint, Credential, Dependency และ Network path มากขึ้น Security ต้องเข้าไปอยู่ใน Platform และ Delivery process
เรื่องพื้นฐานที่ควรมี
- ยืนยันตัวตนและสิทธิ์ของทั้งผู้ใช้และ Service
- เข้ารหัส Traffic ที่ต้องป้องกัน เช่น TLS หรือ mTLS ตาม Threat model
- เก็บ Secret ในระบบจัดการ Secret ไม่ฝังใน Image หรือ Git
- จำกัด Network และสิทธิ์ตาม Least privilege
- ตรวจ Dependency และ Container image
- Rate limit และป้องกัน Abuse ที่จุดเข้า
- เก็บ Audit trail สำหรับงานสำคัญ
- วางแผนหมุน Key, Certificate และ Credential
อย่าโยน Security ทั้งหมดให้ Gateway Service ภายในยังต้องตรวจ Authorization ในระดับ Business ด้วย เช่น User คนนี้อ่าน Order ของใครได้ เพราะ Gateway รู้ว่า Token จริง แต่ไม่ได้อ่านใจ Domain rule แทนเรา
15. ย้ายจาก Monolith แบบไม่ต้องเผาเมืองเดิม
การ Rewrite ทั้งระบบพร้อมกันเสี่ยงมาก เราเสียเวลานานโดยไม่มี Feature ใหม่ และวันเปิดจริงต้องสลับจักรวาลในคืนเดียว
แนวทาง Strangler Fig ค่อย ๆ สร้าง Capability ใหม่ข้างระบบเดิม แล้ว Route Traffic บางส่วนออกไป เมื่อของใหม่มั่นคงจึงปลดของเก่า
ลำดับที่สมเหตุสมผล
- วัดปัญหาเดิมให้ชัด เช่น Deployment ช้า หรือส่วนหนึ่ง Scale ไม่ไหว
- หา Boundary ที่มี Value และขอบเขตค่อนข้างชัด
- สร้าง Contract ด้านหน้าหรือ Anti-corruption layer
- ย้าย Capability หนึ่งส่วน พร้อม Telemetry และ Rollback
- ให้ระบบเก่ากับใหม่ Coexist ชั่วคราว
- ย้าย Traffic ทีละส่วนและตรวจผล
- ลบเส้นทางเก่าเมื่อแน่ใจว่าไม่มีใครใช้งาน
เริ่มจาก Capability ที่มีขอบชัดและสร้างการเรียนรู้ ไม่จำเป็นต้องเริ่มจากหัวใจที่ซับซ้อนที่สุดเพราะคำว่า Challenge ฟังดูดีใน Retrospective
อย่า Extract Service เพื่อย้ายโค้ดเฉย ๆ
ถ้าเรา Copy Module ออกมาเป็น Service แต่ยังใช้ Table เดิม Contract ไม่ชัด และ Release พร้อม Monolith อยู่เหมือนเดิม เราเพียงเพิ่ม Network hop ให้ Code ชุดเดิม
การ Extract สำเร็จต้องย้าย Ownership, Data และวิธี Operate ไปพร้อมกันตามจังหวะที่ปลอดภัย
16. Anti-pattern ที่พบบ่อย
Nano-services
Service เล็กจนทุก Request ต้องเรียกหลายสิบตัว ไม่มีทีมใดเป็นเจ้าของ Business outcome ครบหนึ่งเรื่อง Complexity ย้ายจาก Code เข้า Network โดยไม่ได้สร้างอิสระที่มีค่า
Shared Database แบบใครอยากเขียนอะไรก็เชิญ
ทุก Service ต่อ User เดียวและแก้ Table กันตรง ๆ Schema กลายเป็น API ที่ไม่มี Version และไม่มีเจ้าของ
Synchronous chain ยาว
Gateway เรียก A, A เรียก B, B เรียก C และ C ขอ DNS พิจารณาชีวิต ทุก Hop เพิ่ม Latency และโอกาสพัง
Event soup
ทุกอย่างส่ง Event ชื่อกว้าง ไม่มี Schema ไม่มี Ownership และไม่มีใครรู้ว่าลบ Field ได้หรือยัง ระบบดู Decoupled จนกระทั่งแก้อะไรไม่ได้
Shared library ที่บังคับ Upgrade พร้อมกัน
Library กลางมี Domain model และ Business rule จำนวนมาก ทุก Service ต้องอัปเดตรุ่นพร้อมกัน อิสระจึงกลับไปรวมศูนย์ใน Package manager
Kubernetes cosplay
มี Cluster, Helm, Mesh และ Dashboard ครบ แต่ Deploy เดือนละครั้ง Database ร่วมกัน และ Incident ต้องเรียกทุกทีม เครื่องมือจัดวาง Container ได้ดี แต่แก้ Boundary หรือ Ownership แทนเราไม่ได้
17. Workshop ย่อ: แยกร้านส่งอาหารอย่างไร
ลองใช้ Flow นี้
ลูกค้ากดสั่ง
  → ตรวจเมนูและราคา
  → เก็บเงิน
  → ส่งออเดอร์เข้าครัว
  → หาไรเดอร์
  → แจ้งสถานะลูกค้า
ขั้นแรก วง Business capability
อย่าเพิ่งวาด Service ให้วงคำและกฎที่เกี่ยวกันก่อน
- Catalog รู้เมนู ราคา และ Availability
- Ordering รู้ Basket กับวงจรออเดอร์
- Payment รู้การอนุมัติ เก็บ และคืนเงิน
- Kitchen รู้คิวและสถานะการปรุง
- Delivery รู้ไรเดอร์ เส้นทาง และ Proof of delivery
ขั้นสอง หา Source of truth
| Fact | เจ้าของ |
|---|---|
| ราคาเมนูปัจจุบัน | Catalog |
| ราคาที่ลูกค้าซื้อตอนนั้น | Ordering เก็บ Snapshot |
| สถานะการจ่ายเงิน | Payment |
| สถานะอาหาร | Kitchen |
| ตำแหน่งไรเดอร์ | Delivery |
สังเกตว่าราคาอยู่ได้สองที่โดยมีความหมายต่างกัน Catalog เก็บราคาปัจจุบัน แต่ Order ต้องเก็บ Snapshot เพื่อให้ประวัติไม่เปลี่ยนตามราคาในอนาคต
ขั้นสาม เลือกจุด Sync และ Async
- Checkout ขอราคาและยืนยัน Payment แบบ Sync เมื่อจำเป็นต้องตอบลูกค้า
- หลัง Order ถูกยืนยัน ส่ง
OrderPlacedให้ Kitchen แบบ Async - Kitchen ส่ง
MealReadyให้ Delivery - Delivery ส่งสถานะให้ Notification
ขั้นสี่ วาด Failure ก่อนวาด Happy path เพิ่ม
ถามว่า
- Payment สำเร็จแต่ Kitchen ปฏิเสธงานทำอย่างไร
- Message ซ้ำแล้วครัวจะทำอาหารสองชุดหรือไม่
- Delivery ล่ม ลูกค้ายังดูออเดอร์ได้ไหม
- Event ค้างนานเท่าไรจึง Alert
- ใครมีสิทธิ์กด Retry หรือ Refund
Architecture ที่ดีไม่ได้มีแต่ลูกศรสีเขียว มันรู้ว่าลูกศรเส้นไหนขาดแล้วเกิดอะไรต่อ
18. Readiness Checklist ก่อนประกาศว่าเราจะทำ Microservices
ตอบ “ใช่” ให้ได้หลายข้อพอสมควร
เหตุผลทางธุรกิจและทีม
- มีหลายทีมที่ต้องเปลี่ยนและ Deploy คนละจังหวะ
- Boundary ทางธุรกิจเริ่มชัดและมีเจ้าของ
- ส่วนของระบบมี Scale, Risk หรือ Compliance ต่างกันจริง
- ความเร็วที่ได้มีค่ามากกว่าต้นทุน Operation เพิ่ม
Engineering
- มี Automated test และ CI/CD ที่ไว้ใจได้
- Contract มี Version และตรวจ Breaking change
- ทีมเข้าใจ Timeout, Retry, Idempotency และ Eventual consistency
- มีวิธีจัดการ Schema migration ข้ามเวอร์ชัน
Operations
- มี Structured logs, Metrics และ Distributed traces
- ทุก Service มี Owner, Runbook, SLO และ Alert ที่ลงมือได้
- จัดการ Config, Secret และ Deployment แบบมาตรฐาน
- ทีมรับมือ Partial failure และ Message replay ได้
สัญญาณให้หยุดคิดอีกครั้ง
- เหตุผลหลักคืออยากใช้ Kubernetes
- ยังไม่มีใครตอบว่า Service ไหนเป็นเจ้าของข้อมูลอะไร
- ทุก Feature ต้องแตะทุก Service
- ทีมเดียวต้องดูแล Service มากเกินกว่าจะเข้าใจ
- ไม่มีเวลาเตรียม Observability แต่มีเวลาแตก Repository 30 อัน
ถ้าฝั่งล่างดังเกินฝั่งบน ให้เริ่มจาก Modular Monolith และสร้างวินัยเรื่อง Boundary ก่อน มันไม่ได้ปิดประตู Microservices ในอนาคต ตรงกันข้าม มันช่วยให้เรารู้ว่าจะตัดตรงไหนโดยไม่ต้องโยนเหรียญ
สรุป ระบบกระจายไม่ได้ลบความซับซ้อน มันย้ายที่อยู่ให้ความซับซ้อน
Microservices ช่วยให้ทีม Deploy, Scale และดูแล Business capability ได้อย่างอิสระขึ้น เมื่อ Boundary ดีและองค์กรพร้อมรองรับ
แต่ความอิสระนั้นแลกกับ Network, Partial failure, Data consistency, Contract versioning, Observability, Security และ Operation ที่มากขึ้น Function call ที่เคยเชื่อใจกันใน Process เดียว ตอนนี้ต้องทำ Passport และเดินทางข้ามประเทศ
จุดเริ่มที่ดีที่สุดจึงไม่ใช่คำถามว่า
“เราจะใช้ Tool อะไรทำ Microservices?”
แต่คือ
“ตรงไหนของระบบที่ต้องการอิสระจริง และอิสระนั้นคุ้มกับค่าประสานงานหรือไม่?”
ถ้าคำตอบยังไม่ชัด สร้าง Monolith ที่แบ่ง Module ดี ๆ วัด Pain แล้วเรียนรู้ Domain ต่อไป ถ้าคำตอบชัด ค่อย Extract ทีละ Capability พร้อม Data ownership, Contract, Telemetry และวิธีรับมือ Failure
Architecture ที่ดีไม่ใช่ระบบที่มีกล่องมากที่สุด มันคือระบบที่ทีมเปลี่ยนสิ่งสำคัญได้โดยไม่ต้องปลุกทั้งบริษัทขึ้นมาช่วยกันดู Log
เอกสารอ้างอิงและอ่านต่อ
- Microservices architecture style — Microsoft Azure Architecture Center
- Use domain analysis to model microservices — Microsoft
- Data considerations for microservices — Microsoft
- Identify microservice boundaries — Microsoft
- Transactional outbox pattern — AWS Prescriptive Guidance
- Saga pattern — AWS Prescriptive Guidance
- Circuit breaker pattern — AWS Prescriptive Guidance
- Strangler fig pattern — AWS Prescriptive Guidance
- Observability primer — OpenTelemetry
- Gateway API — Kubernetes